GPU伺服器維護全攻略:關鍵指標、日常保養方法與穩定運算的重要性
部落格 / GPU伺服器維護全攻略:關鍵指標、日常保養方法與穩定運算的重要性
在AI與大數據技術高速發展的時代,數據中心(Data Center)的高效算力成為企業競爭的核心。然而,高負載的運算環境對硬體帶來極大考驗,若缺乏完善的保養策略,將可能導致嚴重的業務中斷與高昂的維修成本。因此,掌握專業的GPU伺服器維護方法、指標及重要性,是每一位IT管理員與企業決策者必須重視的課題。本文將從數據中心的專業角度出發,深入解析如何透過科學化的管理與預測性保養,最大化設備壽命並確保運算穩定性,為企業提供最實用且具權威性的運維指南。
為什麼數據中心不可忽視GPU伺服器維護重要性?
在企業級數據中心中,GPU模組的採購成本極高,且肩負著機器學習、深度學習及高效能運算(HPC)等關鍵任務。維護伺服器,不僅僅是為了保護昂貴的硬體資產,更是為了維持整體業務的連續性。
首先,穩定的維護能大幅降低無預警停機(Downtime)的風險。當伺服器因過熱或硬體故障而停擺時,企業面臨的不僅是維修成本,還有龐大的商業損失。其次,良好的保養能確保算力輸出穩定,避免因高溫降頻(Thermal Throttling)而拖累AI模型的訓練進度。因此,GPU伺服器維護的重要性,核心在於保障企業投資回報率(ROI)及維持系統的高可用性。
評估健康狀態的4大GPU伺服器維護指標
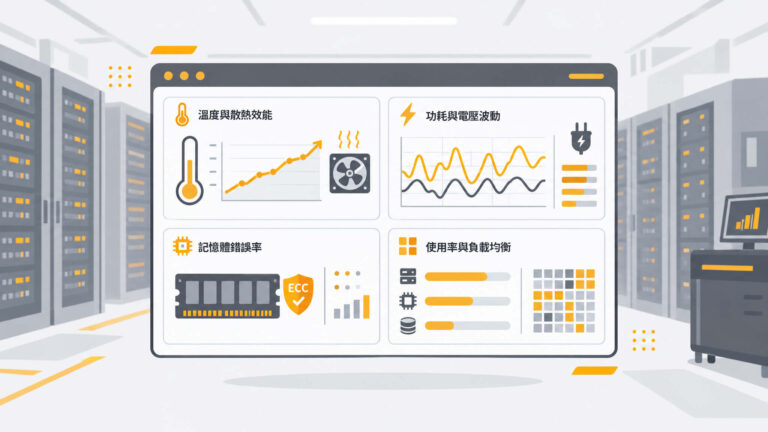
要預防伺服器故障,我們必須學會判讀數據。在日常數據中心營運中,團隊應密切關注以下幾項維護GPU伺服器健康的關鍵指標:
1. 溫度與散熱效能
GPU滿載運作時會產生巨大熱能。核心溫度(Core Temperature)及記憶體溫度是首要監控目標。一般企業級標準建議將溫度維持在70°C至85°C的安全範圍內,若異常飆升,可能意味著散熱介質老化或機房冷卻系統出現異常。
2. 功耗與電壓波動
透過監控功耗(Power Draw),管理員可以了解GPU的實際負載狀況。若發現供電電壓不穩或功耗出現異常的波峰波谷,這通常是電源供應器(PSU)老化或供電模組受損的警號。
3. 記憶體錯誤率(ECC Errors)
企業級GPU通常配備ECC(錯誤更正碼)記憶體。定期檢查ECC錯誤修正次數,是判斷顯示記憶體(VRAM)是否即將損壞的重要指標。當硬體錯誤率急劇上升時,應及早安排節點替換。
4. 使用率與負載均衡
GPU使用率並非越低越好,AI叢集的營運目標正是令昂貴的加速卡保持高負載。真正需要留意的是使用率分佈:同一叢集內部分節點長期滿載、部分長期閒置,代表任務排程失衡,長期滿載的節點會較快消耗散熱與供電元件壽命。結合上述溫度、功耗與ECC指標一併分析,才能判斷哪些節點需要調整排程或提前安排保養。統一收集上述提到的GPU伺服器維護關鍵指標,並結合GPU使用率(Utilization)進行分析,有助於優化任務排程,避免單一設備過勞。
數據中心的GPU伺服器維護方法
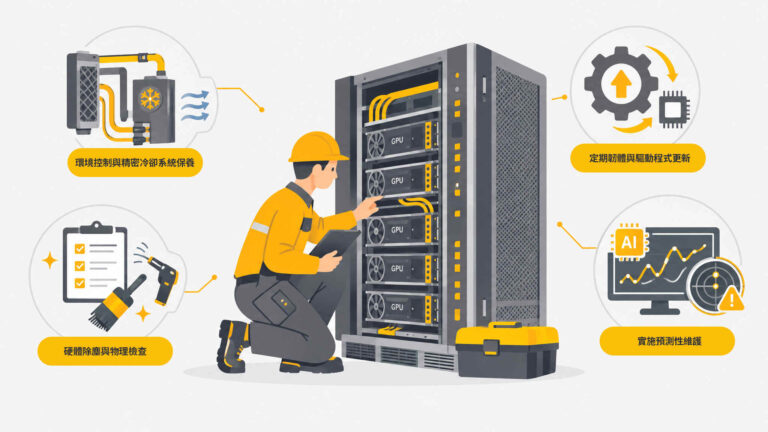
作為數據中心,我們的團隊會根據以下維護方法保持伺服器的良好運作:
1. 環境控制與精密冷卻系統保養
與一般家用電腦不同,數據中心依賴機房級別的精密空調(CRAC)或液冷系統(Liquid Cooling)。因此我們需要確保機房的冷熱通道(Hot/Cold Aisles)順暢、溫濕度符合ASHRAE國際標準,並定期檢查液冷管線是否有微漏或冷卻液變質的問題。
2. 定期韌體與驅動程式更新
系統層級的軟體保養同樣關鍵。這包含定期更新GPU驅動程式、伺服器 BIOS 以及 BMC(基板管理控制器)韌體。這不僅能修補潛在的安全漏洞、改善電源管理,還能提升與最新 AI 框架的相容性。
3. 硬體除塵與物理檢查
即使數據中心具備嚴格的無塵設計,長時間高風量運轉仍會累積微塵,影響散熱風流。安排定期的停機維護窗口(Maintenance Window),使用防靜電工具清理伺服器內部,並檢查PCIe插槽是否穩固,這個方法是維護GPU伺服器不可省略的重要一步。
4. 實施預測性維護(Predictive Maintenance)
導入AI智能監控與DCIM(數據中心基礎設施管理)系統,透過歷史數據與機器學習演算法預測潛在的硬體故障。將過去「損壞後維修」的被動模式,轉變為「故障前預防」的主動出擊,這是現代化數據中心最高效的運維策略。
OneAsia 助您打造高效穩定的 AI 數據中心
建立並執行完善的伺服器保養流程,需要投入大量專業人力與監控軟硬體。OneAsia作為亞太地區領先的IT服務與數據中心解決方案供應商,深知企業在部署 AI 算力時面臨的嚴峻挑戰。我們明白GPU伺服器維護的重要性,因此為您提供全面的AI就緒數據中心解決方案,具備高密度的電力與最先進的冷卻架構,更擁有全天候24/7的專業運維團隊,為您嚴格把關每一台伺服器的健康狀態,讓企業能無後顧之憂地專注於核心業務與AI創新。
隨著人工智能應用的普及,算力基礎設施的穩定性直接決定了企業的競爭優勢。根據系統化的方法及指標維護GPU伺服器,是保障數據中心高效運作的不二法門。若您的企業正在尋求穩定、安全且支援高密度運算的基礎架構,歡迎了解OneAsia的專業服務。
常見問題
1. 如何提升GPU效能?
可透過改善機房散熱與更新驅動程式來提升。散熱不良會導致GPU降頻,維持機房低溫可確保滿載運行;定期更新驅動與韌體,能修補系統瓶頸並提升AI運算相容性。
2. 伺服器故障的原因和解決方法有哪些?
常見原因為過熱、電源不穩及硬體老化。解決方法為部署精密空調或液冷系統防過熱;使用備援電源(UPS)確保電壓穩定;透過監控系統檢查錯誤率,及早替換異常零件。
3. 數據中心多久需要進行一次GPU伺服器保養?
建議每月進行軟體巡檢,每季進行實體硬體維護。每月應檢查溫度、錯誤率等指標並更新韌體;每季則需安排維護窗口,進行伺服器內部除塵與線路檢查,預防硬體故障。
參考資料
- Schneider Electric – Predictive maintenance for AI data center liquid cooling
- iFactory AI – NVIDIA DGX Integration with CMMS Software: Best Practices
- Maintech – AI Data Center Liquid Cooling Monitoring: 7 Must-Have Capabilities